Resumen
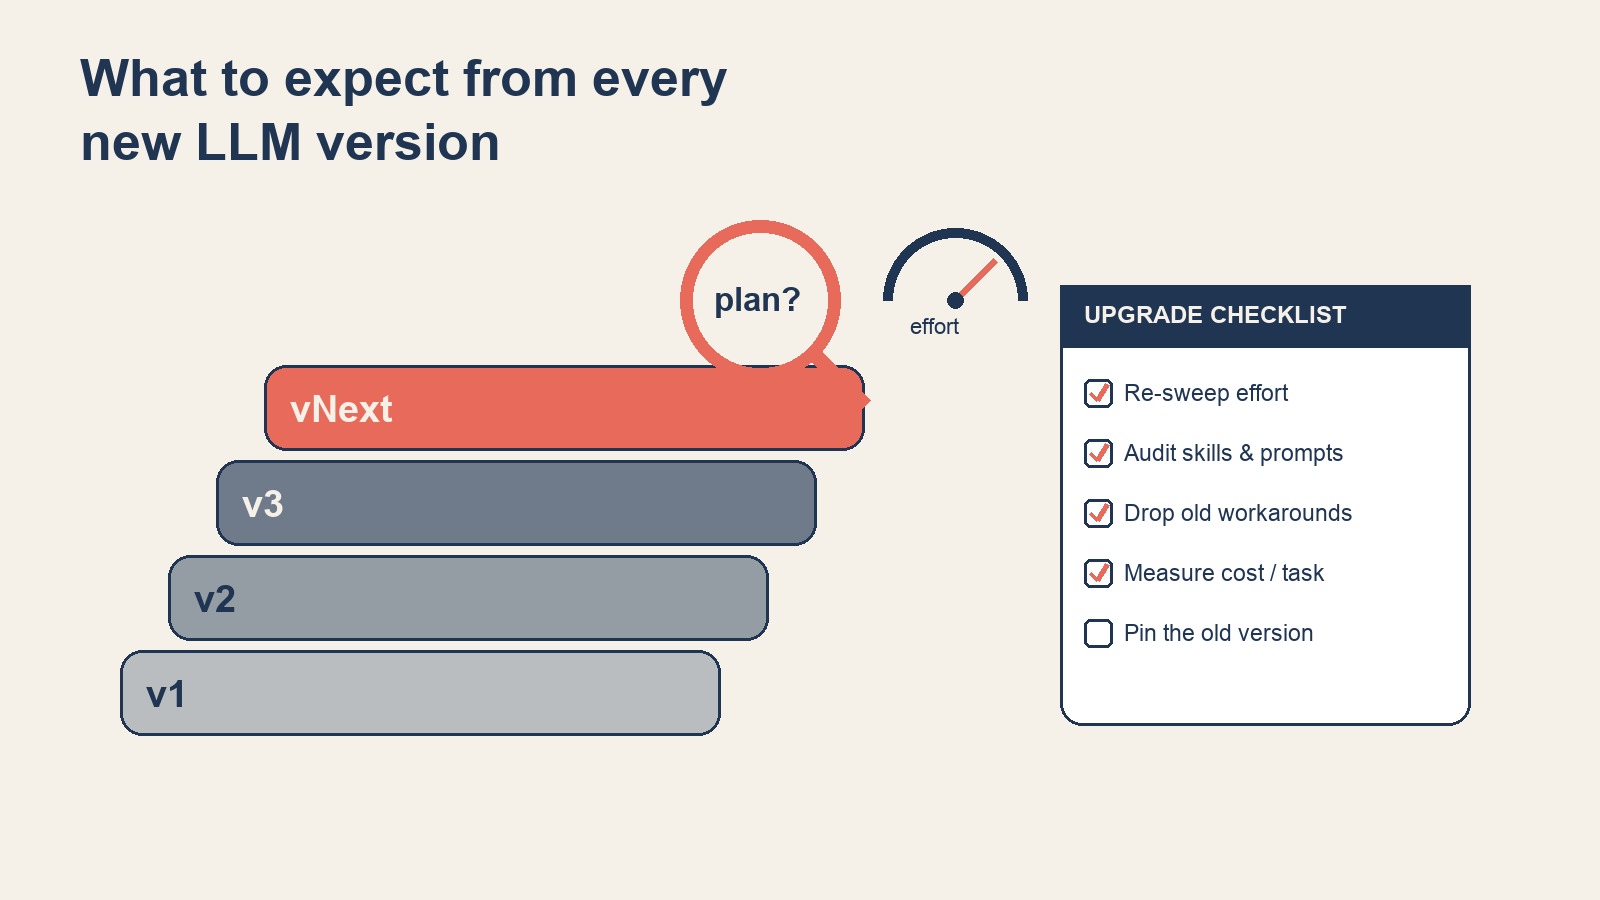
- Una nueva versión es un nuevo compañero de trabajo, no una versión más rápida del anterior. Cambian las capacidades, pero también el comportamiento, los valores predeterminados, la superficie de la API, la estructura de costos, las reglas de seguridad y el harness que rodea al modelo.
- La sorpresa suele estar en la atribución, no en la capacidad. Cuando Opus 5.5 empezó a «planificar por defecto» para un ingeniero en octubre de 2026, tres causas documentadas podían producir ese comportamiento: una configuración de esfuerzo, un cambio en el entrenamiento del modelo o un prompt del harness. La documentación de los proveedores, por sí sola, no permite distinguirlas.
- Tanto Anthropic como OpenAI documentan la revisión de los archivos de instrucciones y la repetición de pruebas con tareas representativas. Sus recomendaciones sobre el esfuerzo difieren: Anthropic indica que vuelvas a probar los niveles de esfuerzo en lugar de conservar la configuración anterior; OpenAI indica que mantengas el nivel efectivo de esfuerzo actual y compares los resultados. Eliminar soluciones alternativas obsoletas es una recomendación específica de Anthropic.
- El costo por token es la unidad equivocada. En Opus 5.5, los precios de entrada y salida bajaron 20%, pero las lecturas de caché bajaron 60%, y Anthropic informa que el costo por tarea se redujo 40% con la configuración predeterminada. Identifica qué tipo de token domina tu carga de trabajo y luego mide los tokens por tarea.
- La lista de siete categorías que aparece a continuación es una inferencia editorial a partir de los lanzamientos de Claude Opus 5.5, GPT-6 Astra y Gemini 4 Argon de septiembre–octubre de 2026. La revisión y la repetición de pruebas que constituyen el núcleo del ritual de la siguiente sección están documentadas por los proveedores; las recomendaciones sobre el esfuerzo difieren. No confundas esos niveles de confianza.
Qué aprenderás aquí
- Un caso práctico: tres causas documentadas para un comportamiento inesperado y la evidencia que permite distinguirlas
- Las siete cosas que vale la pena revisar en cada nueva versión de un LLM, con el nivel de confianza de cada una
- El ritual de actualización que documentan Anthropic y OpenAI, en sus propias palabras, incluidos los puntos en los que discrepan
- Un protocolo de 90 minutos para actualizar versiones que puedes ejecutar antes de cambiar el ID de un modelo en producción
- Un experimento de tres ramas que atribuye un comportamiento inesperado al modelo, al esfuerzo o al harness
- Cómo pensar en el costo cuando los precios por token bajan de forma desigual según el tipo de token
La actualización que no fue solo un cambio de modelo
En octubre de 2026, un ingeniero cambió a Claude Opus 5.5 con el nivel de esfuerzo high y notó algo que no había visto antes: el modelo generaba un plan por defecto. La explicación evidente —«el nuevo entrenamiento hizo que planificara»— resulta ser solo una de tres posibles causas documentadas:
- Esfuerzo. La documentación de Anthropic sobre el esfuerzo dice que los niveles más altos podrían «explicar el plan antes de actuar», mientras que los niveles más bajos «proceden directamente a la acción sin preámbulo». Pero esa sección se aplica de forma general a todos los modelos compatibles con niveles de esfuerzo, y Opus 5 también funcionaba con
highcuando se omitía el nivel de esfuerzo. El esfuerzo explica que aparezca un plan conhigh; no puede explicar por qué apareció ahora, frente a una referencia de Opus 5 con el mismo nivel de esfuerzo. - Cambio en el modelo. La página de novedades de Opus 5.5 informa que hay «más razonamiento por turno con un mismo nivel de esfuerzo» que en Opus 5: un cambio producto del entrenamiento. Pero hay un problema de visualización: los bloques de razonamiento se devuelven con un campo
thinkingvacío bajo la configuración predeterminadadisplay: "omitted", y el texto entre llamadas a herramientas ahora también llega dentro de esos bloques. Por lo tanto, más razonamiento solo se convierte en un plan visible si tu herramienta muestra resúmenes de razonamiento. Esa conexión es una inferencia y depende de una configuración del harness. - Harness. Las herramientas de agentes inyectan sus propias instrucciones. En la sesión que dio origen a este artículo, el harness del entorno inyectó una instrucción de «escribir primero un plan completo» antes de que el modelo hiciera nada: un comportamiento de planificación previa generado por completo fuera del modelo. Si quitar esa instrucción eliminaría el plan es, de nuevo, una inferencia: nunca se probó el escenario alternativo.
La búsqueda de evidencia que corroborara la observación produjo menos resultados de los esperados. Las búsquedas de frases en Hacker News («plans before», «asks before acting») no devolvieron nada, aunque una búsqueda simple de «opus 5.5» devuelve miles de resultados, así que eso demuestra la ausencia de esas frases, no del tema. Los issues de anthropics/claude-code en GitHub contienen un reporte relacionado (issue #103624, 20 de octubre de 2026): un usuario cuyo orquestador de Claude Projects «pregunta en lugar de actuar. Añadió un paso de “¿puedo continuar?” antes de cada acción… En una sesión normal de terminal nada de esto ocurre». No se menciona el modelo, así que el reporte no vincula a Opus 5.5 con la planificación no solicitada, pero un mismo usuario, dos entornos y un comportamiento que aparece en solo uno de ellos es exactamente lo que cabría esperar de una causa relacionada con el harness. Un segundo issue (#105782, 28 de octubre de 2026) menciona a Opus 5.5, pero reporta un comportamiento relacionado en sentido contrario: posponer trabajo relacionado para sesiones futuras.
La conclusión honesta sobre la observación original es: cambio en el entrenamiento plausible, pero no probado. La prueba que permitiría resolverlo aparece en el ejemplo práctico de abajo. Primero, la lección general.
Siete cosas que cambian en cada versión
Inferencia editorial (confianza media): esta clasificación se extrapola de tres lanzamientos de septiembre–octubre de 2026 (Opus 5.5, 22 de septiembre; GPT-6 Astra, 3 de septiembre según la cobertura anterior de este sitio; Gemini 4 Argon, 13 de octubre). Trátala como una lista de cosas que debes verificar, no como una ley.
| # | Qué cambia | Ejemplo de Opus 5.5 (Sep 2026) | Qué hacer |
|---|---|---|---|
| 1 | Las capacidades, de manera desigual | Lidera en programación agéntica; las diferencias en benchmarks son «una guía menos confiable para las diferencias en el mundo real» (en palabras del propio proveedor) | Vuelve a ejecutar tus evaluaciones, no te fíes de la tabla del lanzamiento |
| 2 | El comportamiento y los valores predeterminados, sin aviso | El esfuerzo predeterminado bajó de high → medium; más razonamiento por turno con el mismo esfuerzo; el razonamiento no se puede desactivar | Vuelve a probar los niveles de esfuerzo; compara el comportamiento en las tareas de referencia |
| 3 | La superficie de la API, con cambios incompatibles | Se eliminó el uso forzado de herramientas (400s); los bloques de razonamiento quedaron vinculados al modelo, por lo que cambiar de modelo a mitad de una conversación puede descartar razonamiento previo | Lee la página de novedades o migración, no solo el anuncio |
| 4 | La estructura de costos, de manera desigual según el tipo de token | Entrada/salida −20%, lecturas de caché −60%; costo por tarea −40% con la configuración predeterminada (según el proveedor) | Mide los tokens y el costo por tarea, según el tipo de token |
| 5 | La capa de seguridad | Se añadió un clasificador de biología junto al de ciberseguridad; las respuestas de rechazo ahora incluyen una vía alternativa | Vuelve a probar prompts cercanos a los límites de las políticas; maneja stop_reason: "refusal" |
| 6 | El harness, durante el mismo período | Claude Code 2.1.280 convirtió a Opus 5.5 en el Opus predeterminado; 2.1.284 cambió las sesiones interactivas de terminal y VS Code para que comiencen en modo automático cuando no hay un modo de permisos configurado, en todos los planes y proveedores | Registra la versión del harness junto con la del modelo en cada reporte (consulta también micro-harnesses frente a sistemas operativos agénticos) |
| 7 | Los controles durante la conversación | Esfuerzo por mensaje, presupuestos de tarea, compactación bajo demanda, mensajes de sistema a mitad de la conversación | Diseña ciclos de agentes que puedan ajustar el esfuerzo y el contexto durante la ejecución |
Dos datos de otros proveedores respaldan el patrón. La guía de GPT-6 de OpenAI advierte que Astra es «más sensible a las instrucciones contenidas en skills y otros archivos, como AGENTS.md»: los archivos de prompts que has acumulado tienen más efecto en el nuevo modelo. La publicación de Google sobre Gemini 4 Argon (13 de octubre de 2026) describe un modelo entrenado para detenerse y pedir confirmación humana antes de dar pasos irreversibles, además de un monitor automatizado que lee el razonamiento del agente en tiempo real. La iniciativa, la cautela y la supervisión se reajustan en cada generación, en direcciones distintas según el proveedor.
El ritual de actualización documentado por los proveedores
Esta parte es, en su mayor parte, documentación y no inferencia, con una corrección a la forma habitual de contarla. Cada fuente a continuación es una nota de migración para un solo lanzamiento, así que «haz esto en cada versión» es el patrón que infiero de ellas; lo que cada proveedor dijo realmente aparece entre comillas.
Compartido por ambos proveedores (documentado): revisa los archivos de instrucciones y vuelve a probar con tareas representativas.
- Revisa tus archivos y recursos de prompts. Claude Code 2.1.283 incorporó
/doctor prompt-auditpara revisar «tus archivos CLAUDE.md, skills, agentes y comandos en busca de patrones de prompting escritos para modelos anteriores». La guía de GPT-6 de OpenAI dice: «Recomendamos encarecidamente revisar las skills y otros archivos accesibles para tu modelo en busca de instrucciones que puedan influir en su comportamiento». - Vuelve a probar antes de confiar. La guía rápida de migración de OpenAI acompaña sus recomendaciones sobre el esfuerzo con «compara los resultados en tareas representativas»; la página de novedades de Anthropic indica que configures el esfuerzo explícitamente y vuelvas a probar sus niveles en lugar de trasladar los resultados anteriores.
En qué discrepan: el esfuerzo.
- Anthropic sobre Opus 5.5: «Vuelve a probar los niveles de esfuerzo en lugar de conservar una configuración anterior». Una configuración ajustada para el modelo anterior es una suposición que puede haber quedado obsoleta en el nuevo. (Para ver cuánto importa probar esos niveles, consulta ¿Necesitamos razonamiento profundo?)
- OpenAI sobre GPT-6: «Conserva tu nivel efectivo actual de esfuerzo de razonamiento cuando sea compatible» y luego compara con tareas representativas. Usa la configuración anterior como punto de partida: el enfoque predeterminado opuesto.
Solo Anthropic: elimina las soluciones alternativas obsoletas. «Es posible que las soluciones alternativas de visión en los prompts creadas para modelos anteriores ya no sean necesarias». Cada generación incorpora al modelo soluciones para las que antes recurrías a trucos en los prompts, y los trucos que quedan pueden convertirse en errores de comportamiento.
Si no haces nada más el día de la actualización, revisa tus archivos de instrucciones y vuelve a probar con tus propias tareas. Luego, maneja el esfuerzo como recomienda tu proveedor o, mejor aún, mide ambos enfoques, que es lo que hace el siguiente protocolo.
Implementación: un protocolo de 90 minutos para actualizar versiones
Ejecuta este protocolo antes de que una nueva versión del modelo reciba tráfico de producción. Se asume que tienes un pequeño conjunto de tareas de referencia; si no lo tienes, crearlo es el paso cero.
| Paso | Tiempo | Acción | Resultado |
|---|---|---|---|
| 0 | una vez | Fija 10–20 tareas representativas con criterios de aprobación o fallo, incluida una tarea cercana a un límite de seguridad y otra sensible al costo | Conjunto de referencia en control de versiones |
| 1 | 10 min | Lee la página de novedades y la guía de prompting (no el anuncio). Enumera los cambios incompatibles, los cambios en los valores predeterminados y los parámetros eliminados | Lista de cambios |
| 2 | 15 min | Ejecuta el conjunto de referencia en el modelo anterior y en el nuevo con configuraciones iguales. Registra la tasa de aprobación, los tokens de salida y cualquier diferencia de comportamiento (nivel de detalle, planificación, preguntar frente a actuar) | Tabla de diferencias de comportamiento |
| 3 | 20 min | Prueba los niveles de esfuerzo en el nuevo modelo: low / medium / high con el mismo conjunto. Elige por clase de tarea, no de forma global | Tabla de asignación de niveles de esfuerzo |
| 4 | 15 min | Revisa prompts, skills, CLAUDE.md/AGENTS.md (Claude Code: /doctor prompt-audit). Marca las instrucciones escritas para compensar las debilidades del modelo anterior | Hallazgos de la revisión |
| 5 | 10 min | Elimina o flexibiliza las soluciones alternativas que el nuevo modelo ya no necesita; vuelve a ejecutar las tareas afectadas | Prompts más cortos, misma tasa de aprobación |
| 6 | 10 min | Calcula los costos: tokens por tarea según el tipo (entrada, salida, lectura/escritura de caché) × precios nuevos, modelo anterior frente al nuevo | Diferencia de costo por tarea |
| 7 | 10 min | Fija la versión anterior para poder revertir; despliega la nueva detrás de una flag y adjunta la tabla de diferencias de comportamiento al PR | Despliegue reversible |
La disciplina de registro del paso 2 es lo que los equipos suelen omitir. Anota la forma de cualquier comportamiento inesperado, no solo su existencia. Eso es lo que hace posible la siguiente sección.
Ejemplo práctico: atribuir la «planificación por defecto»
Cuando una nueva versión haga algo inesperado, evita atribuirle una causa hasta que hayas ejecutado la prueba de atribución. Una comparación entre el antes y el ahora dentro de una sola herramienta no puede confirmar un cambio en el modelo: el harness puede haberse actualizado durante el mismo período (consulta el punto 6 anterior). Solo puede descartar causas o mantenerlas como posibilidades. Las ramas que usan la API directamente son las que aíslan el modelo.
flowchart TD
    A[Comportamiento inesperado en la nueva versión] --> B{¿Qué forma toma?}
    B -->|Dentro de un resumen de razonamiento visible| C["Compatible: cambio en el modelo mediante visualización"]
    B -->|Preámbulo en prosa en un bloque de texto| D["Compatible: efecto del esfuerzo"]
    B -->|Lista de tareas, documento de plan, tarjeta de aprobación| E["Compatible: prompt del harness"]
    C --> F["API directa, prompt de sistema vacío<br/>modelo de referencia frente al nuevo, mismo esfuerzo, 3+ ejecuciones"]
    D --> F
    E --> G["Rama del harness: misma herramienta, ambos niveles de esfuerzo, 3+ ejecuciones"]
    F --> H{¿El nuevo modelo planifica más<br/>con el mismo esfuerzo?}
    H -->|Sí| I[Cambio en el modelo - comportamiento aprendido]
    H -->|Solo con esfuerzo high| J[Efecto del esfuerzo]
    G --> K{¿Hay planes en el harness<br/>pero no en la API directa?}
    K -->|Sí| L[Causa en el harness]
    K -->|No| M[Las causas se combinan - cuantifica cada rama]
Ejecuta una pequeña matriz de pruebas y cuenta las frecuencias, porque los efectos documentados son probabilísticos («podría explicar el plan»). Una ejecución no demuestra nada; tres por celda es el mínimo, diez es mejor cuando la diferencia es pequeña:
# Pseudocode — run_once() is your own API/agent call with those settings.
# Attribution sweep: count how often a plan preamble appears per cell.
# Cells: (model, effort, system) — keep prompt and tools identical.
cells = [
    ("baseline-model", "medium", ""), ("baseline-model", "high", ""),
    ("new-model",      "medium", ""), ("new-model",      "high", ""),
]
for model, effort, system in cells:
    plans = sum(run_once(model, effort, system, GOLDEN_TASK).starts_with_plan()
                for _ in range(3))
    print(f"{model} @ {effort}: plan in {plans}/3 runs")
# More plans on new-model at equal effort  -> model change
# Plans only at high, both models          -> effort effect
# Plans in your harness but never here     -> harness cause
En el caso de Opus 5.5 con el que comenzó este artículo, esa prueba no se ha ejecutado. Por eso la conclusión sigue siendo «plausible, pero no probado», en lugar de convertirse en una afirmación sobre el entrenamiento.
Costo: por token no es lo mismo que por tarea
Los precios de Opus 5.5 (septiembre de 2026, según el proveedor) son el ejemplo reciente más claro de por qué las cifras destacadas del precio por token pueden inducir a error:
| Tipo de token | Opus 5 | Opus 5.5 | Cambio |
|---|---|---|---|
| Entrada | $5 / Mtok | $4 / Mtok | −20% |
| Salida | $25 / Mtok | $20 / Mtok | −20% |
| Lecturas de caché | $0.50 / Mtok | $0.20 / Mtok | −60% |
| Escrituras de caché (5 min) | $6.25 / Mtok | $5 / Mtok | −20% |
Anthropic informa que el costo por tarea bajó 40% «con la configuración predeterminada» en cargas de trabajo típicas. Esa cifra combina tres efectos: tokens más baratos, menos tokens por tarea (los reportes de quienes hicieron pruebas van desde el 20–25% menos de tokens de salida que informa Factory —con 5.5 en medium igualando a Opus 5 en high— hasta la mitad de tokens en un benchmark de línea de comandos según Kiro) y un menor esfuerzo predeterminado: 5.5 usa medium por defecto, mientras que Opus 5 usaba high. Atribuir el 40% a un solo factor es un error; en el trabajo agéntico, las lecturas de caché representan la mayor parte del costo, por lo que la reducción de −60% puede importar más que el −20% que aparece en los titulares.
Este patrón no se limita a Anthropic: la guía de GPT-6 de OpenAI informa que «el costo estimado de la API por tarea de Astra fue menor que el de modelos anteriores, pese a su mayor precio por token»: el costo por tarea baja mientras suben las tarifas, la imagen inversa del caso de Opus.
La regla aplicable a otros casos: las reducciones de precios no son uniformes entre tipos de token. Identifica qué tipo domina tu carga de trabajo y luego mide los tokens por tarea antes y después del cambio. En otro lanzamiento, la misma aritmética puede jugar en tu contra: más razonamiento por turno, un nuevo tokenizador o imágenes más grandes pueden contrarrestar unas tarifas más bajas. Esa posibilidad es una inferencia; el hábito de medir, no.
Qué no debes esperar
- No esperes una mejora continua en todo. Algunas actualizaciones menores pueden centrarse principalmente en precios o seguridad. Los modelos de una familia llegan de forma escalonada: Opus 5.5 se lanzó el 22 de septiembre de 2026 y se anunció que Sonnet y Haiku llegarían «en las próximas semanas», así que «la nueva versión» es un período de lanzamiento gradual, no un solo evento.
- No esperes cifras neutrales entre proveedores. Cada laboratorio ejecuta su tabla de lanzamiento en su propio harness. La propia publicación de Anthropic reconoce que, a este nivel, las diferencias en benchmarks se han convertido en «una guía menos confiable para las diferencias en el mundo real».
- No esperes confirmación de la comunidad a demanda. Los reportes de comportamientos relacionados (un orquestador que pregunta antes de actuar; un modelo que pospone trabajo) no son reportes de tu comportamiento específico. Lo relacionado sirve para generar hipótesis, nada más.
- No esperes una causa confirmada sin una prueba que la aísle. Si tu evidencia es «misma herramienta, nuevo modelo, nuevo comportamiento», tienes una correlación con al menos tres posibles causas documentadas.
Fuentes
- Novedades de Claude Opus 5.5 — consultado el 29 de octubre de 2026 — razonamiento siempre activado, esfuerzo predeterminado
medium, más razonamiento por turno, bloques de razonamiento vinculados al modelo y la conversación, eliminación del uso forzado de herramientas. - Esfuerzo — consultado el 29 de octubre de 2026 — «Esfuerzo con uso de herramientas»: un mayor esfuerzo podría «explicar el plan antes de actuar»; los niveles más bajos «proceden directamente a la acción sin preámbulo».
- Prompting para Claude Opus 5.5 — consultado el 29 de octubre de 2026 — orientación contextualizada sobre la tendencia a «ponerse a trabajar rápidamente» y recomendaciones de la lista de verificación.
- Presentamos Claude Opus 5.5 — 22 de septiembre de 2026 — precios por tipo de token, afirmación de una reducción de 40% en el costo por tarea con la configuración predeterminada, reportes de pruebas sobre menos tokens por tarea.
- Registro de cambios de Claude Code — consultado el 29 de octubre de 2026 — 2.1.280 (Opus 5.5 «ahora es el modelo Opus predeterminado»), 2.1.283 (
/doctor prompt-audit), 2.1.284 (las sesiones interactivas de terminal y VS Code comienzan en modo automático cuando no hay un modo de permisos configurado, en todos los planes y proveedores). - Issue de GitHub #103624 — 20 de octubre de 2026 — el orquestador añadió por sí solo un paso de «¿puedo continuar?», ausente en una terminal normal (no se menciona el modelo).
- Issue de GitHub #105782 — 28 de octubre de 2026 — Opus 5.5 pospone trabajo relacionado para sesiones futuras.
- Uso de GPT-6 — consultado el 29 de octubre de 2026 — iniciativa y comportamiento al hacer preguntas, llamadas asíncronas a herramientas, orientación a mitad de turno, recomendación de revisar los archivos de skills; guía rápida de migración: «Conserva tu nivel efectivo actual de esfuerzo de razonamiento cuando sea compatible» y compara con tareas representativas; costo estimado de la API por tarea menor que el de modelos anteriores pese a un precio por token más alto.
- Gemini 4 Argon — 13 de octubre de 2026 — entrenamiento para detenerse antes de pasos irreversibles, monitor de desalineación en tiempo real.