Resumen
- No hay un solo ganador en el
lowde Anthropic. El trabajo elige el id. Tope de latencia con una revisión de contenido: Sonnet 5.5low. Documento exacto, cuando una declaración de diferencia no paga la cuenta: Opus 5.5low. Reinicio caro: Fable 5.1low. Haiku 5.5lowno superó ninguna de las dos suites duras de abajo. lowson cuatro ajustes que comparten una palabra. En el archivo de skill en caché el 2026-10-06, Fable 5.1 y Sonnet 5.5 usanhighpor defecto. Opus 5.5 y Haiku 5.5 usanmedium. Si omites el campo, no estás en esta comparación.- En declaraciones de impuestos exactas, la ventaja de Fable es una declaración de 50. TaxCalcBench llama
lobotomizedallowde Anthropic. Sin herramientas, las declaraciones estrictas son 12% (Fable, 6 de 50), 10% (Opus 5.5, 5 de 50), 4% (Sonnet 5.5) y 0% (Haiku 5.5). La precisión estricta por línea queda casi empatada arriba: 71.81% frente a 71.39%. Fable cuesta cerca del triple que Opus y espera casi el doble. - En una compuerta de perfiles de 10 segundos, Sonnet 5.5 en
lowsostiene el piso de contenido y pierde el reloj en dos de tres muestras. Cada tipo de perfil se queda en 95% o más. El reloj estricto aprueba la muestra 1. Las muestras 2 y 3 fallan en 10.4 s y 10.3 s. Opus 5.5 low y Haiku 5.5 low fallan el contenido y el reloj. Fable no estaba en ese barrido. - Opus 5.5 en
lowfalló seis reconstrucciones que el brazo medium aprobó. Low aprobó 17 de 23. Medium aprobó 23 de 23, y tres de esas corridas medium incluyeron respuestas de respaldo de Opus 4.8. En una llamada de diagnóstico, Fable 5.1 enlowgastó 893 tokens de pensamiento. Opus 5.5 enlowgastó cero. - Fija cuatro roles si corres un roster al estilo de Orca. Smol: Sonnet 5.5 en
low. Default: Sonnet 5.5 enhigh. Slow: Opus 5.5 enmedium. Asesor: Sonnet 5.5 enmedium. Si dejas un rol sin definir,smoloslowcopiandefault. El asesor copiaslow.
Qué aprenderás aquí
- Cuál es el id del Fable actual, y cuánto cuesta
lowen precio de lista según la tabla de skill del 2026-10-06 - Por qué una fila de benchmark llamada
lowpuede significarmediumde Anthropic - Cómo se comparan los cuatro modelos cuando la palabra
lobotomizeddel benchmark sí es ellowde Anthropic - Cuándo dejar
lowy subir amedium - Una tabla de rutas pequeña que puedes pegar en un cliente
- Qué esfuerzo fijar en
smol,default,slowy el asesor
El artículo de julio comparó Fable 5, Opus 4.8 y Sonnet 5 en low. Este no reutiliza esas puntuaciones. El artículo de latencia del 2 de noviembre trata de high y max. Los precios y los valores por defecto de abajo pueden moverse. Quedan fechados en la página que abrimos.
Cuatro modelos, una palabra
Claude Fable 5.1 (claude-fable-5-1) es el Fable actual de distribución amplia en el skill claude-api de Anthropic, tabla en caché el 2026-10-06. Fable 5 sigue en servicio. Mythos 5.1 tiene el mismo precio a través de Project Glasswing, y queda fuera de esta comparación.
Precio de lista en esa tabla, por millón de tokens:
| Modelo | Entrada | Salida |
|---|---|---|
| Fable 5.1 | $10 | $50 |
| Opus 5.5 | $4 | $20 |
| Sonnet 5.5 | $2 | $10 |
| Haiku 5.5, prompt hasta 100K tokens | $0.10 | $0.50 |
| Haiku 5.5, prompt por encima de 100K tokens | $0.50 | $2.50 |
El esfuerzo vive en output_config, no en el nivel superior de la solicitud. Los valores son low, medium, high, xhigh y max. El SDK de Python dice que un esfuerzo más alto puede tardar más.
En Fable 5.1 y Opus 5.5, thinking: {type: "disabled"} devuelve un 400 en cualquier esfuerzo. La profundidad es el dial de esfuerzo. Sonnet 5.5 también rechaza disabled. Para apagar el pensamiento de Sonnet, el skill dice enviar thinking: {type: "between_tools"}, y solo en high o menos. Haiku 5.5 acepta disabled en high o menos, incluido low, y rechaza esa combinación en xhigh o max. La guía de migración recomienda high para la mayor parte del trabajo con Fable 5.1, xhigh cuando lo que importa es la capacidad, y medium o low para el trabajo de rutina. También dice que los ajustes más bajos, incluido low, siguen rindiendo muy bien y a menudo superan a modelos anteriores en xhigh o max. Esa frase no trae un conteo. Tómala como la afirmación del proveedor.
El mismo archivo de skill te dice que uses low para subagentes y tareas simples, y al menos high cuando el trabajo es sensible a la inteligencia. Los niveles de Sonnet 5.5 se recalibraron desde Sonnet 5, así que un low que afinaste en la generación anterior es un ajuste nuevo.
Las declaraciones de impuestos son la suite low de cuatro modelos
TaxCalcBench puntúa declaraciones de impuestos llenas. Un acierto estricto significa que cada línea calificada coincide. Obtuvimos el README el 2026-11-02. No imprime una fecha de corrida aparte para cada fila de Claude.
Lee los nombres de nivel antes que las puntuaciones. Para estos modelos de Claude, el README mapea sus palabras así:
| Palabra del benchmark | effort de Anthropic |
|---|---|
lobotomized | low |
low | medium |
medium | high |
high | xhigh |
ultrathink | max |
Cada número de impuestos de este artículo es una fila lobotomized. Eso es el low de Anthropic. Su fila llamada low es el medium de Anthropic, y no la usamos.
Sin herramientas, 50 casos, una corrida cada uno:
| Modelo | Declaraciones estrictas | Declaraciones lenientes | Costo | Tiempo |
|---|---|---|---|---|
| Fable 5.1 | 12% | 24% | $0.50 | 54.78 s |
| Opus 5.5 | 10% | 22% | $0.17 | 29.13 s |
| Sonnet 5.5 | 4% | 8% | $0.09 | 22.14 s |
| Haiku 5.5 | 0% | 0% | $0.01 | 33.30 s |
Las declaraciones estrictas, la cuenta y la espera no eligen el mismo modelo.
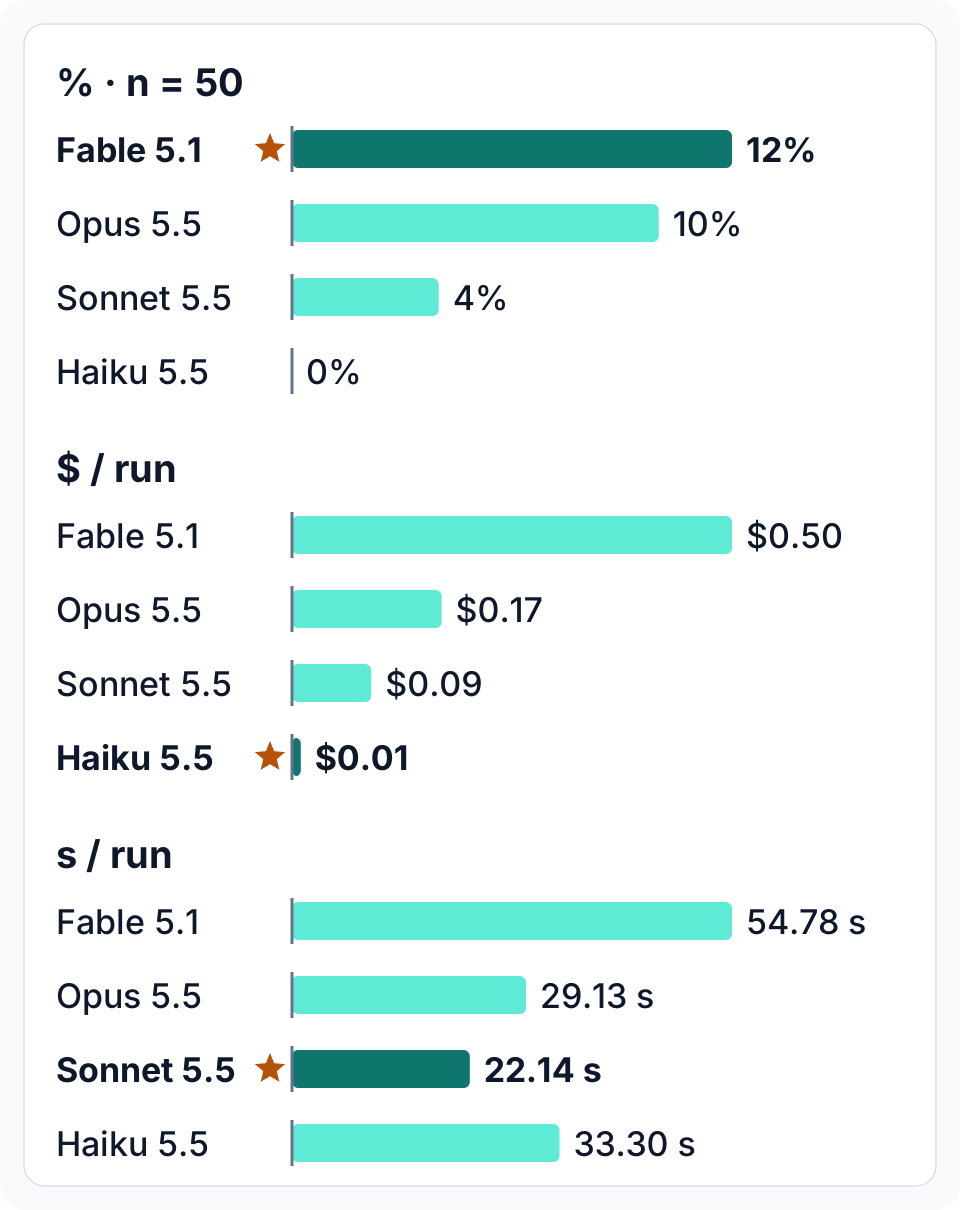
Las cuatro filas sin herramientas de la tabla anterior, en el low de Anthropic, 50 casos, una corrida cada uno. Paneles de arriba abajo: declaraciones estrictas (porcentaje), costo por corrida (dólares), tiempo por corrida (segundos). Todas las barras empiezan en cero; una estrella marca el mejor valor de cada panel. La tabla conserva las puntuaciones lenientes.
Las puntuaciones por línea son más altas que las puntuaciones por declaración. La precisión estricta por línea va de Haiku en 55.51% a Fable en 71.81%. Una declaración puede tener la mayoría de las líneas bien y aun así fallar la compuerta estricta.
Con búsqueda web, todavía en el low de Anthropic, las declaraciones estrictas son 18% (Fable, 0.18, 25.62 s), 4% (Sonnet, 0.02, 42.69 s). La búsqueda sube a Fable y a Opus. Sonnet se queda en 4%. Haiku pasa de 0% a 2%.
Fable 5.1 en low lidera este banco de pruebas en estricto por una declaración: 6 de 50 frente a 5 de 50. La precisión estricta por línea es 71.81% frente a 71.39%, así que las líneas cuentan casi la misma historia y la declaración completa no. Fable cuesta cerca del triple que Opus (0.17) y espera 54.78 s frente a 29.13 s. Opus 5.5 en low es la compra práctica de coincidencia exacta, salvo que esa declaración extra se pague sola en tus formularios. Sonnet es el más rápido de los cuatro y falla la mayoría de las declaraciones. Haiku es el más barato y, sin herramientas, estrictamente correcto en ninguna de las 50 declaraciones. Haiku también es más lento que Sonnet aquí (33.30 s frente a 22.14 s).
El README trata la cifra en dólares de la búsqueda web de Haiku como un límite superior, porque los totales de tokens del bucle de búsqueda pueden inflar la cuenta cerca de un 30%. La cifra de $0.02 de arriba es ese límite superior.
Estas son puntuaciones de llenado de formularios. No son una razón para presentar una declaración real con ninguno de estos modelos. La mejor tasa estricta en el ajuste low sin herramientas es 12%.
Un reloj cambia al ganador
El PR 54470 de Fleet es otro trabajo. El pull request se cerró sin merge el 2026-10-25 a las 8:47 p. m., America/Lima. La tabla del barrido sigue en ese cuerpo cerrado. Una fila pasa solo cuando cada tipo de perfil se queda en 95% o más y cada generación termina dentro de 10 segundos. Fable está ausente. Las filas del barrido no dicen si el pensamiento estaba apagado.
| Configuración | Total | Más de 10 s | Más lenta | Compuerta |
|---|---|---|---|---|
| Sonnet 5.5 low, muestra 1 | 96.9% | 0 | 9.2 s | pass |
| Sonnet 5.5 low, muestra 2 | 96.6% | 1 | 10.4 s | fail |
| Sonnet 5.5 low, muestra 3 | 97.4% | 1 | 10.3 s | fail |
| Opus 5.5 low | 89.7% | 24 | 59.6 s | fail |
| Haiku 5.5 low, muestra 1 | 87.7% | 22 | 12.7 s | fail |
| Haiku 5.5 low, muestra 2 | 86.9% | 20 | 12.4 s | fail |
Las barras son la generación más lenta de cada fila. La línea es el tope de 10 segundos.
xychart-beta
    title "Generación más lenta frente a un tope de 10 segundos"
    x-axis ["Sonnet 1", "Sonnet 2", "Sonnet 3", Opus, "Haiku 1", "Haiku 2"]
    y-axis "Segundos" 0 --> 70
    bar [9.2, 10.4, 10.3, 59.6, 12.7, 12.4]
    line [10, 10, 10, 10, 10, 10]
Sonnet 5.5 en low mantiene cada tipo de perfil en 95% o más en las tres muestras. El reloj estricto aprueba solo la muestra 1. Las muestras 2 y 3 fallan por una generación, en 10.4 s y 10.3 s. Eso es 0.4 s y 0.3 s por encima de un tope de 10 segundos. El texto del PR dice que Sonnet low supera ambas compuertas en las tres muestras. La columna Compuerta dice pass, fail, fail. Usa la columna.
Opus 5.5 en low es más lento y menos preciso en esta suite: 89.7% total, 24 generaciones por encima de 10 segundos, la más lenta en 59.6 s. Haiku 5.5 en low no llega al piso de contenido en ninguna de las dos muestras. Un reloj perdido en Sonnet no es razón para cambiar a Opus en este trabajo. Opus es peor en los dos ejes que mide la suite.
El PR cerrado es el barrido. Lo que corre Fleet es un archivo posterior. En main, tal como se obtuvo el 2026-11-02, mobileconfig, DDM y CSP usan claude-sonnet-5-5 en low. Android usa claude-haiku-5-5 en low con el pensamiento apagado. Mobileconfig y CSP ponen disableThinking: true. DDM deja el pensamiento encendido. El comentario del archivo dice que Sonnet 5.5 en low fue el único modelo que superó ambas barras para cada tipo en la comparación, y que apagar el pensamiento de Sonnet acortó las generaciones más lentas de Windows y mobileconfig. Esa bandera de producción no está escrita en la tabla del PR cerrado. Para Sonnet 5.5, el control del skill para apagar el pensamiento es between_tools. No abrimos el helper que mapea disableThinking a ese campo.
Reconstrucción y una sola llamada
VulcanBench corrió solo Opus 5.5, en 23 tareas de reconstrucción de legado, del 22 al 24 de septiembre de 2026. Low aprobó 17 de 23, en 13.7 minutos promedio, a 2.84. Tres de esas corridas medium incluyeron respuestas de Opus 4.8 después de un respaldo por rechazo (6.4% de las respuestas). Los dólares son el precio de lista equivalente a la API de Claude Code, no una factura en efectivo. Low es más barato y más rápido, y falla seis tareas que el brazo medium aprobó. Algunos de esos aciertos de medium fueron sesiones de modelos mezclados. No hay un brazo de Fable, Sonnet o Haiku. Esto no ordena a los cuatro modelos. El brazo puro de Opus 5.5 low dejó caer tareas. El brazo medium las completó, y algunas de esas sesiones incluyeron el respaldo de Opus 4.8.
Una llamada emparejada muestra por qué Fable low y Opus low son productos distintos. El 2026-10-02, FaultMaven repitió una solicitud real de diagnóstico, una vez por ajuste. Fable 5.1 en low reportó 4,124 tokens de salida, de los cuales 893 fueron de pensamiento, y tardó 52 segundos. Opus 5.5 en low reportó 1,948 tokens de salida, de los cuales 0 fueron de pensamiento, y tardó 21 segundos. Una llamada es una revisión de mecanismo, no una tabla de posiciones. En esta solicitud, el low de Fable sí pensó. El low de Opus no.
Una tabla de agentes en lenguaje Q es fácil de malinterpretar como el ranking de este artículo. Las filas de sala limpia, con el skill apagado, son las que hay que leer. Fable 5.1 aprobó 161 de 164 tareas a 0.085 el 30 de septiembre. Sonnet 5.5 aprobó 158 de 164 a $0.041. La página dice que esas filas usan el manejo de esfuerzo por defecto de Claude Code. No están fijadas en low. Una ventaja de una tarea a cerca del triple del costo de Opus es una razón débil para hacer de Fable el valor por defecto. La ventaja de una declaración en el banco de pruebas de impuestos merece la misma cautela. Igual la mostramos, porque es la única suite de cuatro modelos en el low de Anthropic que abrimos, y porque las brechas de costo y de tiempo son grandes.
Enruta según el trabajo
Esta ruta es un juicio sobre las suites de arriba. Tu repo puede invertirla. Mide antes de congelarla.
| Trabajo | Empieza | Sube cuando |
|---|---|---|
| Generación revisada en menos de unos 10 segundos | Sonnet 5.5 en low | Quédate en Sonnet. Sube el esfuerzo, o falla la solicitud. Opus 5.5 low fue más lento y menos preciso en la suite de perfiles. Fable no se midió ahí |
| Documento exacto, cada campo calificado debe coincidir | Opus 5.5 en low | Tu propio conjunto muestra que la declaración estricta extra vale el costo de Fable. En el banco de pruebas de impuestos esa brecha fue 1 declaración de 50 |
| Trabajo ambiguo, o un fallo caro de reiniciar | Fable 5.1 en low | Low sigue fallando la revisión. Entonces prueba medium en ese mismo id antes de agregar un segundo modelo |
| Reconstrucción larga en el sentido de VulcanBench | Opus 5.5 en medium | Medium sigue fallando. Fable no se midió aquí. Recuerda que el brazo medium incluyó algunas respuestas de respaldo de Opus 4.8 |
| Llamadas masivas que no has probado | Haiku 5.5 en low, detrás de un verificador | El verificador falla. En las dos suites duras de arriba, Haiku low ya falló. Esta fila es un marcador, no una victoria medida |
flowchart TD
  A["Tarea nueva"] --> B{"¿Verificador y un reloj corto?"}
  B -->|Sí| C["Sonnet 5.5 en low"]
  C --> C2{"¿Pasan el contenido y el reloj?"}
  C2 -->|No| C3["Sube el esfuerzo de Sonnet o falla la solicitud"]
  B -->|No| R{"¿Reconstrucción larga?"}
  R -->|Sí| M["Opus 5.5 en medium"]
  R -->|No| D{"¿Cada campo debe coincidir?"}
  D -->|Sí| E["Opus 5.5 en low"]
  E --> J{"¿Un acierto extra vale Fable?"}
  J -->|Sí| G["Fable 5.1 en low"]
  D -->|No| F{"¿Un fallo es caro de reiniciar?"}
  F -->|Sí| G
  F -->|No| H["Haiku 5.5 en low, y luego verifica"]
El cliente tiene que enviar el esfuerzo. El ejemplo deja el pensamiento adaptativo, lo cual es válido en los cuatro ids. No envía thinking: {type: "disabled"}. Ese campo es un 400 en Fable 5.1 y Opus 5.5 en cualquier esfuerzo, y también en Sonnet 5.5. Haiku 5.5 lo acepta en low.
# output_config.effort is Anthropic's dial.
# TaxCalcBench's word "lobotomized" is this "low".
# Their word "low" is Anthropic "medium". Do not copy it across.

ROUTES = {
    "latency_capped": ("claude-sonnet-5-5", "low"),
    "exact_document": ("claude-opus-5-5", "low"),
    "costly_restart": ("claude-fable-5-1", "low"),
    "reconstruction": ("claude-opus-5-5", "medium"),
    # Placeholder. Haiku 5.5 at low failed both hard suites in this article.
    "bulk_untested": ("claude-haiku-5-5", "low"),
}

def claude_body(job: str, messages: list) -> dict:
    model, effort = ROUTES[job]
    return {
        "model": model,
        "max_tokens": 16000,
        "thinking": {"type": "adaptive"},
        "output_config": {"effort": effort},
        "messages": messages,
    }
Si ya tienes un enrutador, usa el bucle de evaluación de Cómo implementar y evaluar una política de enrutamiento de modelos con esfuerzo Low para puntuar los resultados aceptados. Las claves de trabajo de la tabla de arriba reemplazan la división de ese artículo en rutinario, normal y ambiguo. Fija el esfuerzo desde esta tabla. No conserves la división de julio y te limites a renombrar los ids de modelo.
Fija slow, default, smol y el asesor
Orca arranca un worker con un modelo y un esfuerzo. oh-my-pi nombra los cuatro roles de chat que parten ese trabajo: smol, default, slow y advisor. Las fijaciones de abajo son un juicio sobre las suites de este artículo, más el momento en que esos roles se disparan. No son un benchmark de Orca ni de oh-my-pi.
Fija cada rol. La documentación de modelos, abierta el 2026-11-03, dice que un smol o un slow sin definir copia un default explícito. Un asesor sin definir copia slow, no el modelo de la conversación. Deja el asesor en blanco y el modelo profundo lee cada turno.
| Rol | Cuándo corre | Fijación | Paso |
|---|---|---|---|
smol | Fan-out barato | Sonnet 5.5 | low |
default | Cada turno primario | Sonnet 5.5 | high |
slow | El pase profundo que pides | Opus 5.5 | medium |
advisor | Cada turno primario, como entrada | Sonnet 5.5 | medium |
smol es el paso de subagente. El archivo de skill apunta low a subagentes y tareas simples. Sonnet 5.5 en low es la fijación, porque sostuvo el piso de contenido en la suite de perfiles. Haiku 5.5 en low no. Fable es el precio equivocado para un fan-out.
default es el worker abierto, así que no se sienta en low. El valor de catálogo de Sonnet 5.5 en la tabla de skill del 2026-10-06 es high. Usa low en este id solo para el trabajo con reloj de la tabla de rutas: un verificador y unos 10 segundos. Un reloj perdido se queda en Sonnet.
slow es el paso hacia arriba, así que no empieza en low. Opus 5.5 en medium es la fijación. En VulcanBench, low aprobó 17 de 23 y medium aprobó 23 de 23. Tres de esas corridas medium incluyeron respuestas de Opus 4.8. Fable no estaba en esa suite. Pasa a Fable 5.1 en low solo cuando tu propio conjunto muestra que el acierto estricto extra paga la cuenta. En el banco de pruebas de impuestos esa brecha fue una declaración de 50.
El asesor es un revisor, no un segundo ejecutor. La documentación del asesor, abierta el 2026-11-03, dice que un selector sin sufijo de esfuerzo pide medium, y la cadencia por defecto revisa cada turno primario. Sonnet 5.5 en medium es esa petición, fijada para que no pueda heredar slow. Fable 5.1 en low igual gastó 893 tokens de pensamiento en la única llamada de diagnóstico. Eso encaja mal con un lector que corre cada turno. Conserva las herramientas por defecto del asesor: read, grep y glob. La documentación dice que existen herramientas que mutan. Déjalas apagadas salvo que confíes en ese modelo en ese espacio de trabajo.
oh-my-pi escribe el sufijo como :low, :medium o :high en el rol. mapEffortToAnthropicAdaptiveEffort envía un nivel sin mapa como la misma palabra en output_config.effort. minimal es la excepción. El cable adaptativo no tiene minimal, y el mapeador envía ese nivel como low. No escribas :minimal en estos roles de Claude y lo trates como un paso propio.
modelRoles:
  smol: anthropic/claude-sonnet-5-5:low
  default: anthropic/claude-sonnet-5-5:high
  slow: anthropic/claude-opus-5-5:medium
  advisor: anthropic/claude-sonnet-5-5:medium
Confirma esos ids con omp models antes de guardar el archivo. Un asesor configurado que no resuelve no cae a otro modelo.
En un worker claude de Orca, las mismas fijaciones son banderas de arranque. --effort exige --model. El resto del comando es el arranque normal de worker de Orca. Lee el recibo. launch.effective es el modelo que de verdad arrancó.
# smol. Swap the model and effort for default, slow, and the adviser.
orca orchestration worker-start --task <task_id> --worktree current \
  --agent claude --model claude-sonnet-5-5 --effort low
Un worker omp no toma el esfuerzo de esa bandera. El catálogo omp de Orca, commit 5913a1c66 (2026-10-31, 10:45 p. m., America/Lima), enciende la selección de modelo en el arranque y no adjunta opciones de esfuerzo a las filas descubiertas. Pon los cuatro sufijos en modelRoles. El issue 23388 seguía abierto el 2026-11-03. Su última actualización fue el 2026-10-03 a las 5:43 a. m., America/Lima. El catálogo creció un camino --model desde ese reporte, y la lista de esfuerzo de esas filas sigue vacía.
Errores frecuentes
- Leer el
lowde un benchmark como ellowde Anthropic. En TaxCalcBench, para esta generación de Claude,lowsignificamedium. Las filas dellowde Anthropic están etiquetadaslobotomized. - Omitir el esfuerzo y llamar low a la corrida. Fable 5.1 y Sonnet 5.5 entonces corren en
high. Opus 5.5 y Haiku 5.5 corren enmedium. - Importar la puntuación de CursorBench de Fable 5 de julio. Ese era otro modelo.
- Coronar a Fable desde una tabla de agentes con esfuerzo por defecto. Pregunta qué esfuerzo envió el harness.
- Esperar que Haiku 5.5 en
lowsea a la vez el más barato y el más rápido. En el banco de pruebas de impuestos es el más barato, y Sonnet termina antes. En la suite de perfiles de Fleet no llega al piso de contenido. - Dejar el asesor sin definir. Copia
slow. Entonces pagas el modelo profundo en cada turno.
Fuentes
- Skill claude-api de Anthropic — tabla en caché el 2026-10-06. Ids de modelo, precios de lista, esfuerzos por defecto, y la nota de que
lowapunta a subagentes y tareas simples.platform.claude.comno se abrió para este borrador. - Migrar a Claude Fable 5.1 — abierto el 2026-11-02. División de esfuerzo recomendada, y la frase del proveedor de que
lowa menudo supera a modelos anteriores enxhighomax. - SDK de Python de Anthropic,
OutputConfigParam— abierto el 2026-11-02. Valores de esfuerzo delowamax. Un esfuerzo más alto puede tardar más. - README de TaxCalcBench — obtenido el 2026-11-02. Mapa de niveles para estos modelos de Claude, y las filas
lobotomizedusadas arriba. Las fechas de corrida por fila no están impresas. Las tasas de declaración estricta en ellowde Anthropic se mantienen bajas en términos absolutos. El costo de búsqueda web de Haiku es el límite superior del README. - PR 54470 de Fleet — cerrado sin merge el 2026-10-25, 8:47 p. m., America/Lima. Barrido del generador de perfiles. La columna Compuerta y la frase del resumen no coinciden.
- Generador de perfiles de Fleet en main — obtenido el 2026-11-02. Ids de producción y esfuerzo para cada tipo de perfil. El PR cerrado es el barrido. Este archivo es lo que corre la rama.
- Trazas de VulcanBench para Opus 5.5 — corridas del 22 al 24 de septiembre de 2026. Solo Opus, cinco niveles de esfuerzo, 23 tareas de reconstrucción.
- Issue 1800 de FaultMaven, comentario de la medición — medido el 2026-10-02. Una llamada de diagnóstico por ajuste.
- Tabla de evaluación Q — Fable 5.1 el 1 de octubre de 2026; Opus 5.5 y Sonnet 5.5 el 30 de septiembre de 2026. Manejo de esfuerzo por defecto, no
low. - Roles de modelo de oh-my-pi — abierto el 2026-11-03.
smol,default,slowyadvisor. Unsmoly unslowsin definir copian undefaultexplícito. Un asesor sin definir copiaslow. - Asesor de oh-my-pi — abierto el 2026-11-03. Sin sufijo de esfuerzo pide
medium. La cadencia de revisión por defecto es cada turno primario. Las herramientas por defecto sonread,grepyglob. mapEffortToAnthropicAdaptiveEffortde oh-my-pi — abierto el 2026-11-03. Un nivel sin mapa se envía como la misma palabra enoutput_config.effort.minimalse envía comolow.- Catálogo de arranque omp de Orca — commit
5913a1c66, 2026-10-31, 10:45 p. m., America/Lima. El arranque de modelo está encendido. Las filas descubiertas no traen opciones de esfuerzo. - Issue 23388 de Orca — seguía abierto el 2026-11-03. Última actualización el 2026-10-03, 5:43 a. m., America/Lima. Pide que
worker-startpase--modely--effortpara el agenteomp.