Resumen
- Las versiones más recientes fueron más lentas con esfuerzo high y max en las tres comparaciones de capturas. Del 16 de agosto al 2 de noviembre de 2026, la latencia en max aumentó 12.6 veces para Opus, 3.6 veces para Sonnet y 2.2 veces para GPT. Sonnet en high casi no cambió.
- Un umbral del Intelligence Index no limitó la latencia. Las filas de Claude 5.5 que alcanzaron o superaron 50 variaron entre 37.6 y 734 segundos. Los mayores aumentos aparecieron con esfuerzo high y max.
- Una tabla de clasificación no puede decirte si la entrega se ralentizó. Registra las llamadas por tarea, la tasa de aprobación, las rondas de revisión y los minutos hasta el merge. Evalúa esos resultados antes de retirar una configuración.
Nuestro equipo enrutaba el trabajo con Claude a configuraciones de esfuerzo high y max, y exigía un Intelligence Index de Artificial Analysis (AA) superior a 50. Las llamadas parecían más lentas después de las actualizaciones de modelos. Queríamos saber si las versiones realmente se habían vuelto más lentas y si la regla de +50 estaba ayudando.
Las capturas públicas muestran dónde cambió la espera, pero no permiten aislar la causa. Un experimento del equipo debe determinar si la regla de enrutamiento ayuda a la entrega.
Qué cambió con la misma etiqueta de esfuerzo
Comparé el tiempo de respuesta de extremo a extremo para las mismas etiquetas de esfuerzo en las capturas de AA del 16 de agosto y del 2 de noviembre. AA define el tiempo de extremo a extremo como el procesamiento de la entrada, el razonamiento y la generación de la respuesta. Son capturas no controladas: las versiones de los modelos, la infraestructura del proveedor, el tráfico y las operaciones del benchmark pueden diferir entre fechas.
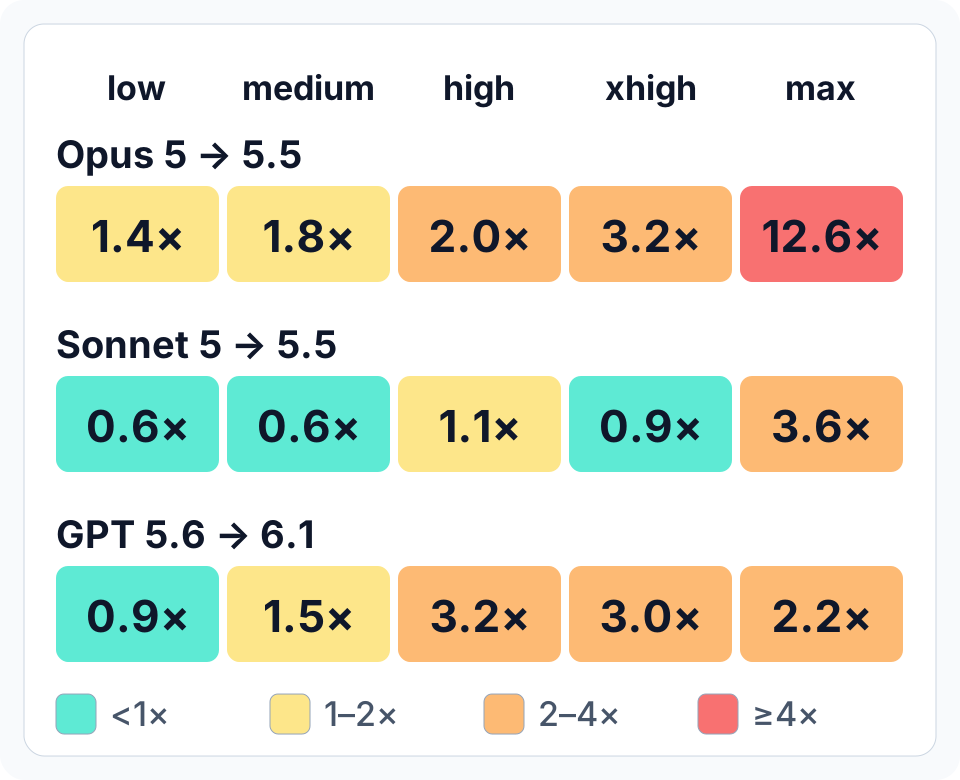
Proporción de latencia de extremo a extremo: la captura del 2 de noviembre dividida entre la del 16 de agosto. Los valores superiores a 1 indican que la fila posterior tardó más. Las proporciones usan los valores de AA sin redondear. Los intervalos de color son menos de 1×, 1–2×, 2–4× y 4× o más; la proporción mostrada es el valor exacto.
Datos de la gráfica de proporciones entre versiones
- Opus 5 a 5.5: low 1.4×, medium 1.8×, high 2.0×, xhigh 3.2×, max 12.6×.
- Sonnet 5 a 5.5: low 0.6×, medium 0.6×, high 1.1×, xhigh 0.9×, max 3.6×.
- GPT-5.6 Sol a GPT-6.1 Sol: low 0.9×, medium 1.5×, high 3.2×, xhigh 3.0×, max 2.2×.
High y max se volvieron más lentos en las tres líneas de modelos. El aumento no fue uniforme: Opus en max saltó de 58.5 a 734 segundos, mientras que Sonnet en high solo pasó de 16.1 a 17.3 segundos. Low y medium se movieron en ambas direcciones.
Los valores de high y max muestran la magnitud. Opus pasó de 26.8 a 53.8 segundos en high y de 58.5 a 734 en max. Sonnet pasó de 16.1 a 17.3 y de 142.4 a 519. GPT pasó de 24.5 a 77.1 y de 149.9 a 337.
Esta no es una regla universal para las actualizaciones. El paso anterior de GPT fue en sentido contrario: GPT-5.6 Sol redujo a menos de la mitad las esperas en high y xhigh frente a GPT-5.5. Emparejé esas versiones por su nombre; AA no afirma que sean un par controlado de antes y después.
La mediana de tiempo hasta el primer fragmento de AA aumentó junto con la mayor parte del aumento de la mediana total. Al dividir esos dos cambios, el resultado es de al menos 84% para cada fila donde aumentó el tiempo total. Esto no es un desglose de una sola solicitud: la tabla de clasificación informa medianas independientes y no indica si el primer fragmento corresponde al primer token de razonamiento o al primer token de respuesta.
La velocidad de salida posterior al primer token que informa AA aumentó para cada etiqueta de esfuerzo en ambas líneas de Claude. Opus en max pasó de 62 a 96 tokens por segundo, aproximadamente un 55% más en la carga de trabajo de AA. Eso coincide en dirección con la afirmación de Anthropic de que Opus 5.5 genera salida más de 30% más rápido que Opus 5, aunque las cargas de trabajo son distintas.
Los modelos que conservaron sus nombres se mantuvieron mayormente estables en la mediana. En cinco pares de capturas, la proporción mediana se mantuvo entre 0.97 y 1.03. Los valores extremos sí cambiaron: nueve de las 33 filas con el mismo nombre al menos duplicaron su tiempo. Sonnet 5.5 en max, por ejemplo, pasó de 389 segundos el 16 de octubre a 519 segundos el 2 de noviembre, mientras que high se mantuvo entre 16 y 18 segundos de agosto a noviembre.
La conclusión práctica es acotada: vuelve a revisar high y max después de una actualización. No supongas que todas las configuraciones se volvieron más lentas.
Por qué falla la regla de +50
La captura de Claude 5.5 del 2 de noviembre deja ver el problema. Dentro de esta captura, todas las filas usan la misma versión del índice.
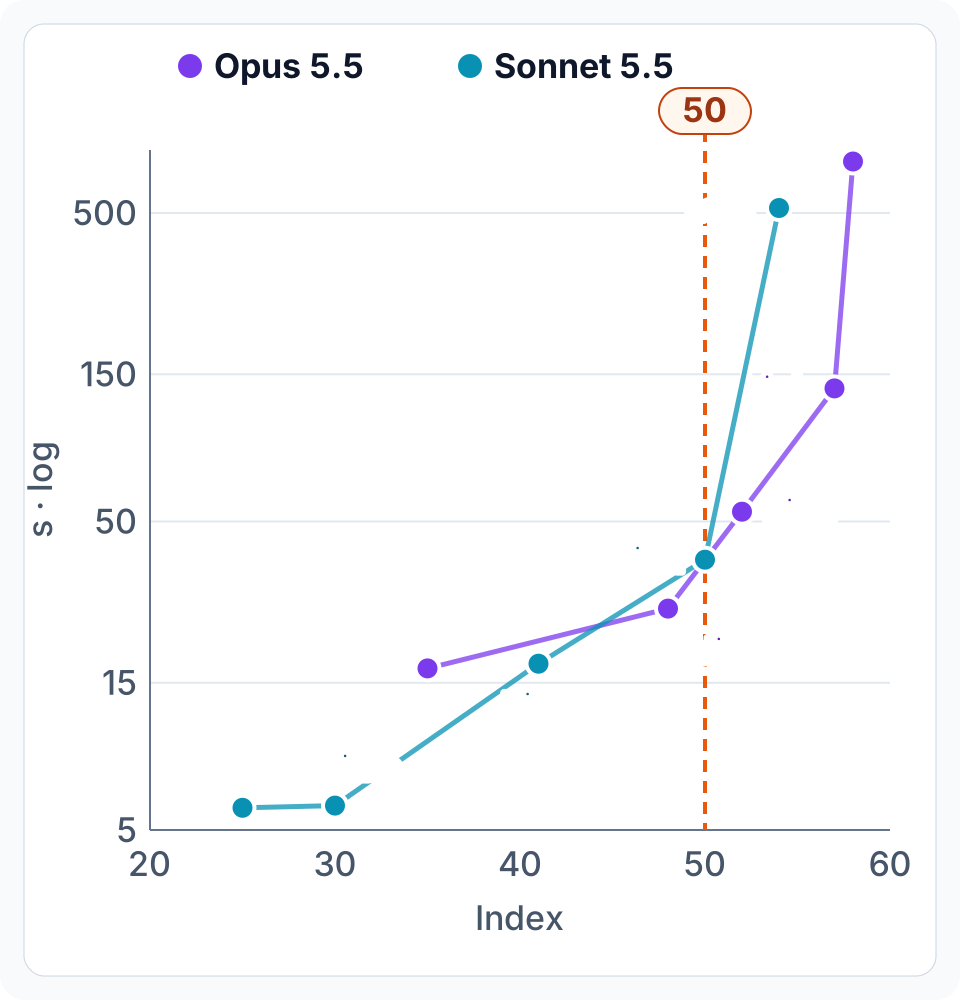
Configuraciones de esfuerzo de Claude 5.5 el 2 de noviembre de 2026. El eje de latencia es logarítmico y la línea vertical marca un índice de 50. Las líneas conectan niveles de esfuerzo categóricos; no implican un ajuste continuo.
Datos de la gráfica de índice y latencia
- Opus 5.5: low 35 / 16.7s, medium 48 / 26.1s, high 52 / 53.8s, xhigh 57 / 135s, max 58 / 734s.
- Sonnet 5.5: low 25 / 5.9s, medium 30 / 6.0s, high 41 / 17.3s, xhigh 50 / 37.6s, max 54 / 519s. Cada par representa el índice / la latencia de extremo a extremo.
Las filas cercanas a la línea tienen esperas muy distintas. Sonnet en xhigh está en 50 y tarda 37.6 segundos. Opus en high obtiene 52 y tarda 53.8 segundos. Sonnet en max obtiene 54 y tarda 519 segundos.
El contraejemplo más contundente es Opus en xhigh frente a Sonnet en max. Opus obtiene una puntuación mayor (57 frente a 54), requiere menos espera (135 frente a 519 segundos) y cuesta menos en el benchmark de AA ($6.05 frente a $10.02). Gana en las tres métricas de AA, aunque eso no demuestra que vaya a rendir mejor en nuestras tareas.
Las filas de GPT muestran la misma dispersión. GPT-6 Astra en medium obtiene 51 y tarda 13.9 segundos; GPT-6.1 Terra en max también obtiene 51, pero tarda 269 segundos. Una puntuación del índice puede servir para filtrar por calidad en el benchmark. No puede servir como política de latencia.
Incluso cruzar la línea no permite separar la puntuación del esfuerzo. Opus pasa de 48 a 52 puntos del índice entre medium y high, mientras la latencia aumenta de 26.1 a 53.8 segundos. Sonnet pasa de 41 a 50 entre high y xhigh, mientras la latencia aumenta de 17.3 a 37.6. Esos dos pares sugieren que el esfuerzo es la palanca, pero no lo demuestran.
El umbral también se mueve cuando AA cambia el índice. Opus 5.5 en medium obtuvo 51 el 16 de octubre y 48 el 2 de noviembre, después del cambio a la versión 5.0. La etiqueta del modelo se mantuvo igual; la puntuación cruzó nuestra línea de enrutamiento.
En esta captura, el esfuerzo se relaciona más estrechamente con la espera que el umbral de +50. Entre nueve familias de modelos que tienen ambas configuraciones, ocho tardaron entre 17 y 88 veces más en max que en low, a cambio de entre 11 y 29 puntos más en el índice. Max aún podría justificar esa espera, pero la puntuación por sí sola no puede demostrarlo.
Lo que el benchmark no puede decirnos
Estas comparaciones tienen cuatro límites importantes:
- Las versiones del índice cambiaron. AA publicó el índice 5.0 el 27 de octubre. Un cambio de puntuación entre capturas no demuestra que haya cambiado la calidad del modelo.
- Las etiquetas de esfuerzo pueden ocultar cantidades distintas de cómputo.
highen una versión puede no representar el mismo trabajo quehighen la siguiente. - Algunas filas de Claude llevan una etiqueta de fallback. AA no define esa etiqueta en la tabla de clasificación de modelos, así que no pude verificar su efecto en la latencia. No puede explicar todo el patrón: GPT-6.1 Sol no tiene esa etiqueta y aun así aumentó entre 2.2 y 3.2 veces en high y max.
- La tabla de clasificación mide el tiempo de prompts individuales. No incluye tus llamadas a herramientas, intentos fallidos ni ciclo de revisión.
Una llamada más lenta aún puede terminar una tarea antes si el modelo necesita menos llamadas. También puede ocurrir lo contrario:
tiempo de tarea ≈ llamadas al modelo × espera por llamada + tiempo de herramientas + tiempo de revisión
AA no informa las llamadas por tarea para nuestro flujo de trabajo. Tenemos que medir ese multiplicador nosotros mismos.
Implementación: ejecuta una prueba piloto de cuatro grupos
Empieza con una fila por tarea completada:
task_id,arm,model,effort,started_at,merged_at,model_calls,review_rounds,passed_first_tryEjecuta la misma combinación de tareas en cuatro grupos, con las mismas pruebas de aceptación y el mismo estado del repositorio:
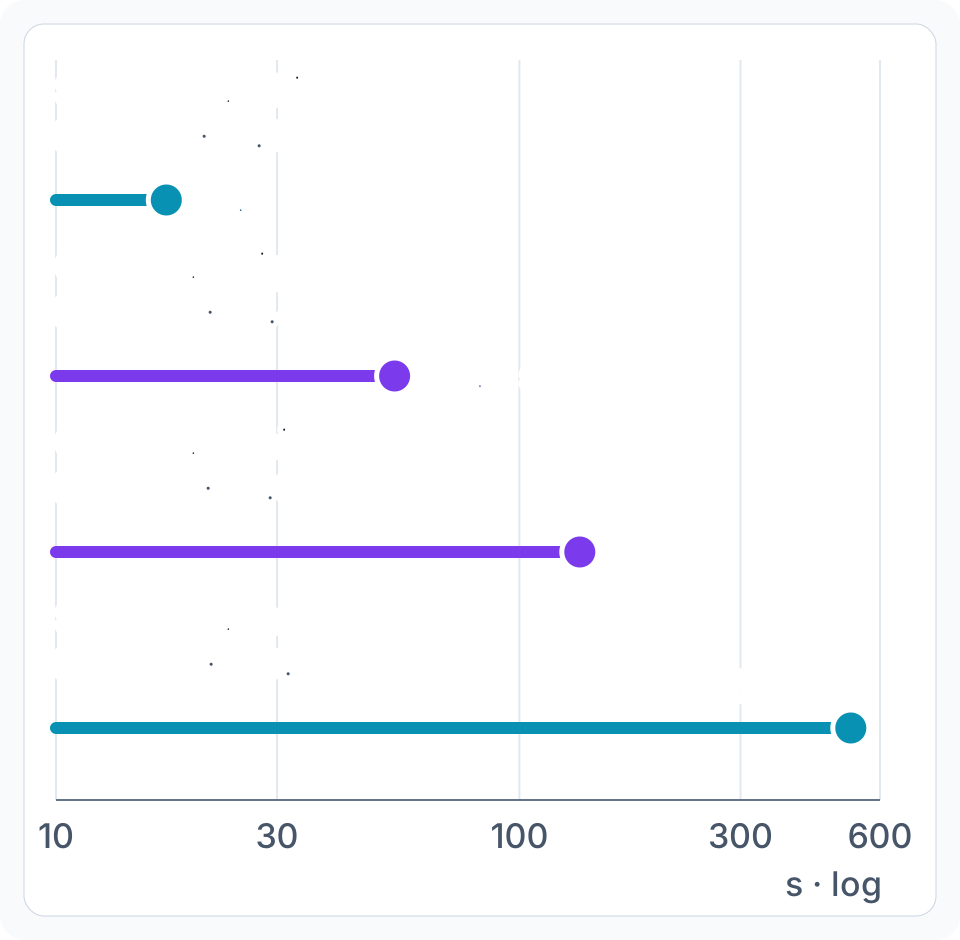
Los cuatro grupos de la prueba piloto con los valores de AA del 2 de noviembre. El costo es el costo de benchmark de AA por tarea del Intelligence Index, no la factura esperada para una tarea de programación del equipo.
Datos de la gráfica de los grupos de la prueba piloto
- Sonnet 5.5 high, prueba del umbral: índice 41, 17.3s, $1.64.
- Opus 5.5 high, grupo económico con +50: índice 52, 53.8s, $3.46.
- Opus 5.5 xhigh, alternativa a max: índice 57, 135s, $6.05.
- Sonnet 5.5 max, configuración actual: índice 54, 519s, $10.02.
Mide la mediana de minutos hasta el merge y de llamadas al modelo, junto con la tasa de aprobación al primer intento y las rondas de revisión. Una prueba piloto pequeña puede revelar grandes diferencias operativas, pero no puede demostrar que las tasas de aprobación sean equivalentes. Si un margen de calidad de cinco puntos va a determinar la decisión, calcula el tamaño de muestra para ese margen e informa los intervalos de confianza.
Empareja tareas similares entre los grupos cuando sea posible y fija las reglas de asignación antes de que comience la prueba. De lo contrario, un grupo podría recibir las tareas más difíciles. Registra los fallos y las intervenciones humanas en lugar de descartarlos; ambos forman parte del tiempo de entrega.
- Reemplaza Sonnet max solo si otro grupo cumple la prueba de calidad declarada de antemano y llega al merge más rápido.
- Elimina el requisito de +50 para una clase de tareas si Sonnet high aprueba con la misma frecuencia que los grupos por encima del umbral.
- Mantén max donde produzca una ventaja clara en la tasa de aprobación o en las rondas de revisión.
flowchart TD
  P["Prueba piloto emparejada de cuatro grupos: tasa de aprobación, llamadas, revisiones, tiempo hasta el merge"] --> Q{"¿Opus xhigh cumple el criterio de calidad?"}
  Q -->|sí| R{"¿Llega al merge más rápido que Sonnet max?"}
  R -->|sí| S["Reemplazar Sonnet max para esta clase de tareas"]
  R -->|no| K["Mantener Sonnet max"]
  Q -->|no| K
  P --> F{"¿Sonnet high iguala a los grupos por encima de 50?"}
  F -->|sí| D["Eliminar el umbral de +50"]
  F -->|no| H["Mantener el umbral para esta clase de tareas"]
Usa los resultados de entrega medidos para ambas decisiones. Repite la prueba piloto cuando cambie el modelo, el harness o la combinación de tareas.
Para una implementación de enrutamiento más completa, consulta Cómo implementar y evaluar una política de enrutamiento de modelos con esfuerzo Low.
Tres resultados cambiarían la política inicial:
- Si max reduce las llamadas o las rondas de revisión lo suficiente para mantener estable el tiempo hasta el merge, sus llamadas más lentas no están ralentizando la entrega.
- Si Opus xhigh no alcanza el margen de calidad acordado, mantén Sonnet max para las clases de tareas donde gana.
- Si una fila medium por encima de 50 de la misma versión se vuelve mucho más lenta que las filas medium por debajo de 50, vuelve a examinar la afirmación de que el esfuerzo importa más que el umbral.
Conclusión
Deja de enrutar basándote únicamente en la puntuación del índice. Como hipótesis para la prueba piloto, empieza el trabajo rutinario en high, prueba xhigh para cambios más grandes y reserva max para tareas donde mejore los resultados lo suficiente como para compensar la espera. Los resultados del equipo deben prevalecer sobre esa asignación. Las llamadas por tarea y los minutos hasta el merge, no la tabla de clasificación, deben determinar la configuración.
Lecturas relacionadas
- ¿Necesitamos razonamiento profundo? Por qué Fable 5.1 y Astra parecen inteligentes y Gemini 3.8 Flash parece tonto: el argumento a favor del esfuerzo por prompt y cuándo pensar más perjudica.
- Qué esperar de cada nueva versión de un LLM: guía práctica para la próxima actualización: qué cambia entre versiones y cómo atribuir comportamientos sorprendentes.
Fuentes
- Artificial Analysis, tabla de clasificación de LLM, consultada el 2026-11-02. Índice v5.0, tiempo de extremo a extremo, latencia del primer fragmento, velocidad de salida y costo por tarea. Estos valores cambian; las cifras de este artículo corresponden a las observaciones del 2026-11-02.
- Artificial Analysis, capturas de la tabla de clasificación: 2026-04-16, 2026-06-16, 2026-08-16, 2026-10-16.
- Artificial Analysis, Metodología de benchmarks de rendimiento de API de modelos de lenguaje, versión 2.2.0 con fecha 2026-03-02. Definiciones y la mediana de 72 horas para cargas de trabajo estándar.
- Artificial Analysis, Metodología de benchmarks de inteligencia. Historial de versiones del índice.
- Artificial Analysis, Presentación de Artificial Analysis Intelligence Index v5, 2026-10-27.
- Artificial Analysis, página principal, consultada el 2026-11-02. La definición de costo por tarea.
- Anthropic, Presentación de Claude Opus 5.5, 2026-09-22. Afirmación sobre la velocidad de salida.